Hardware · Aufbau · Anlagenklassen

So ist ein KI-Server aufgebaut.
Baugruppe für Baugruppe.

Sie kennen Racks, Storage und Ihr eigenes Rechenzentrum. Diese Seite zeigt, wo eine KI-Anlage davon abweicht: welche Baugruppe die Auslegung bestimmt, worin sich die Bauarten unterscheiden und welche Klasse zu welcher Anwendung gehört — und mit dem Systemplan, der das passende Gerät benennt.

Unverbindlich · Terminvorschlag nach Eingang

Einmal durch die Anlage.

Acht Stationen, von der Gesamtansicht bis zum Out-of-Band-Zugang. Beim Scrollen rückt die aktive Baugruppe in die Mitte der Szene; daneben steht, was sie unter KI-Last leistet. Die Optionskarten geben auf Klick den Entscheidungsgrund frei.

Schematische Illustrationen der Baugruppen, keine Fotos der gelieferten Geräte. Was in Ihrer Anlage steht, benennt der Systemplan.

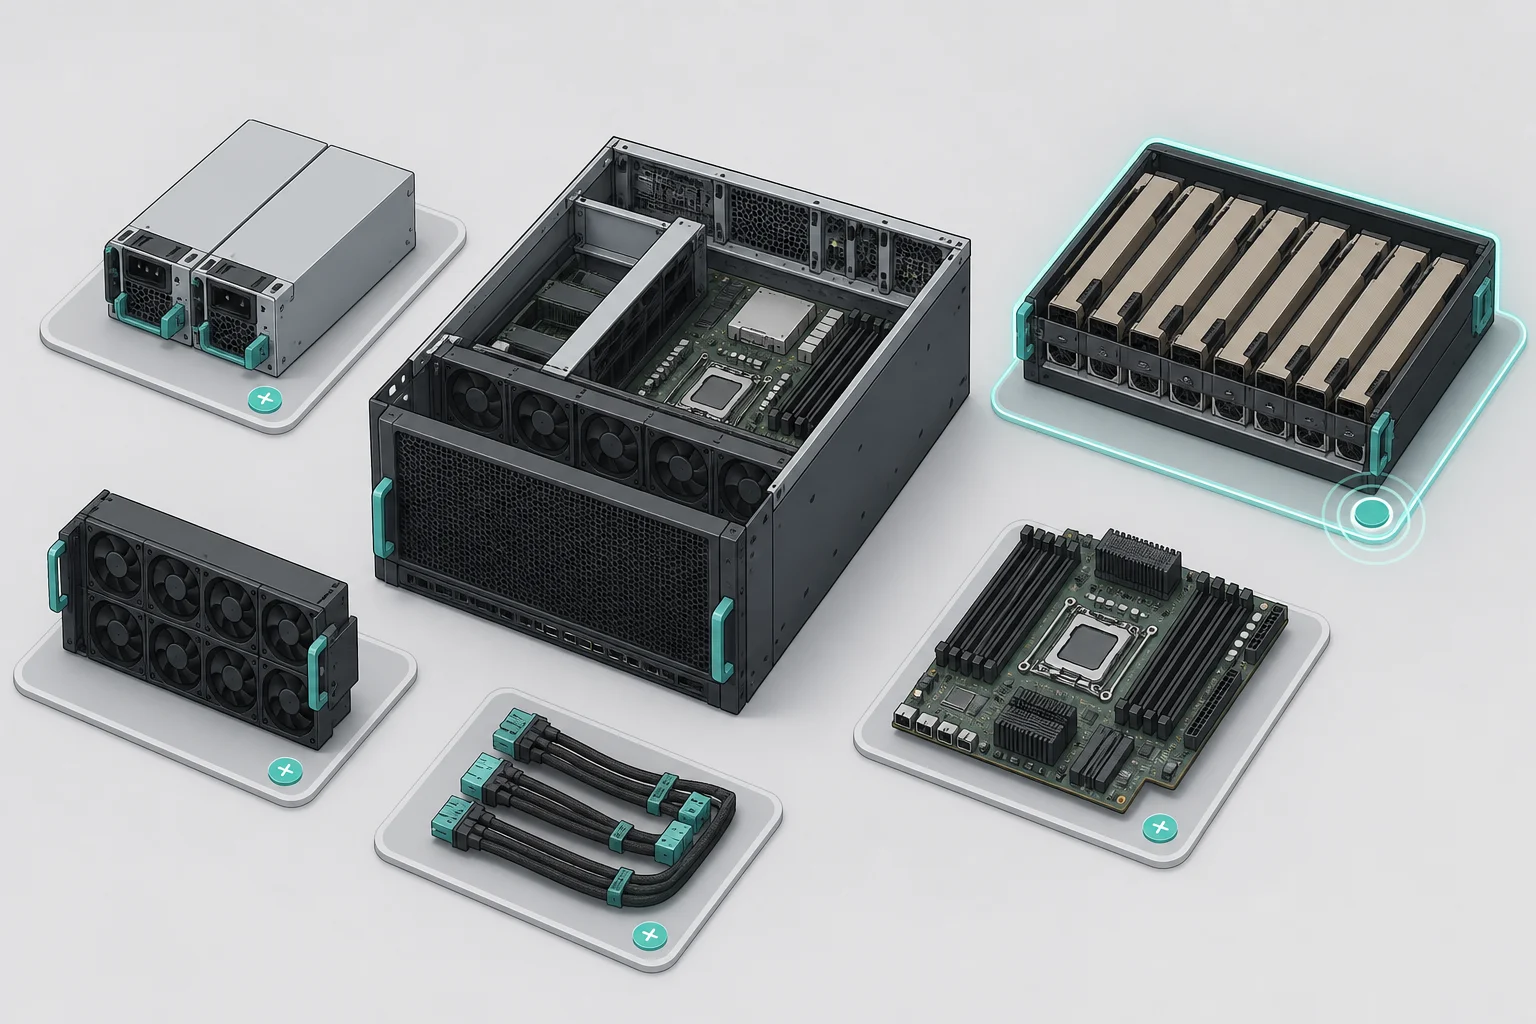
Illustration: sechs Baugruppen einer KI-Anlage isometrisch auf hellen Sockeln, in der Mitte das geöffnete Servergehäuse mit Lüfterreihe und Hauptplatine.

01

Überblick

Sie betreiben Server, Storage und ein eigenes Netz. Eine KI-Anlage nutzt dieselbe Mechanik: 19-Zoll-Einschübe, redundante Netzteile, Front-to-Back-Luft. Sie verschiebt eine Größe — der Grafikspeicher wird zur bindenden Ressource der Auslegung. Die Stationen zeigen, wo Ihr Bestandswissen trägt und wo KI-Last anders rechnet.
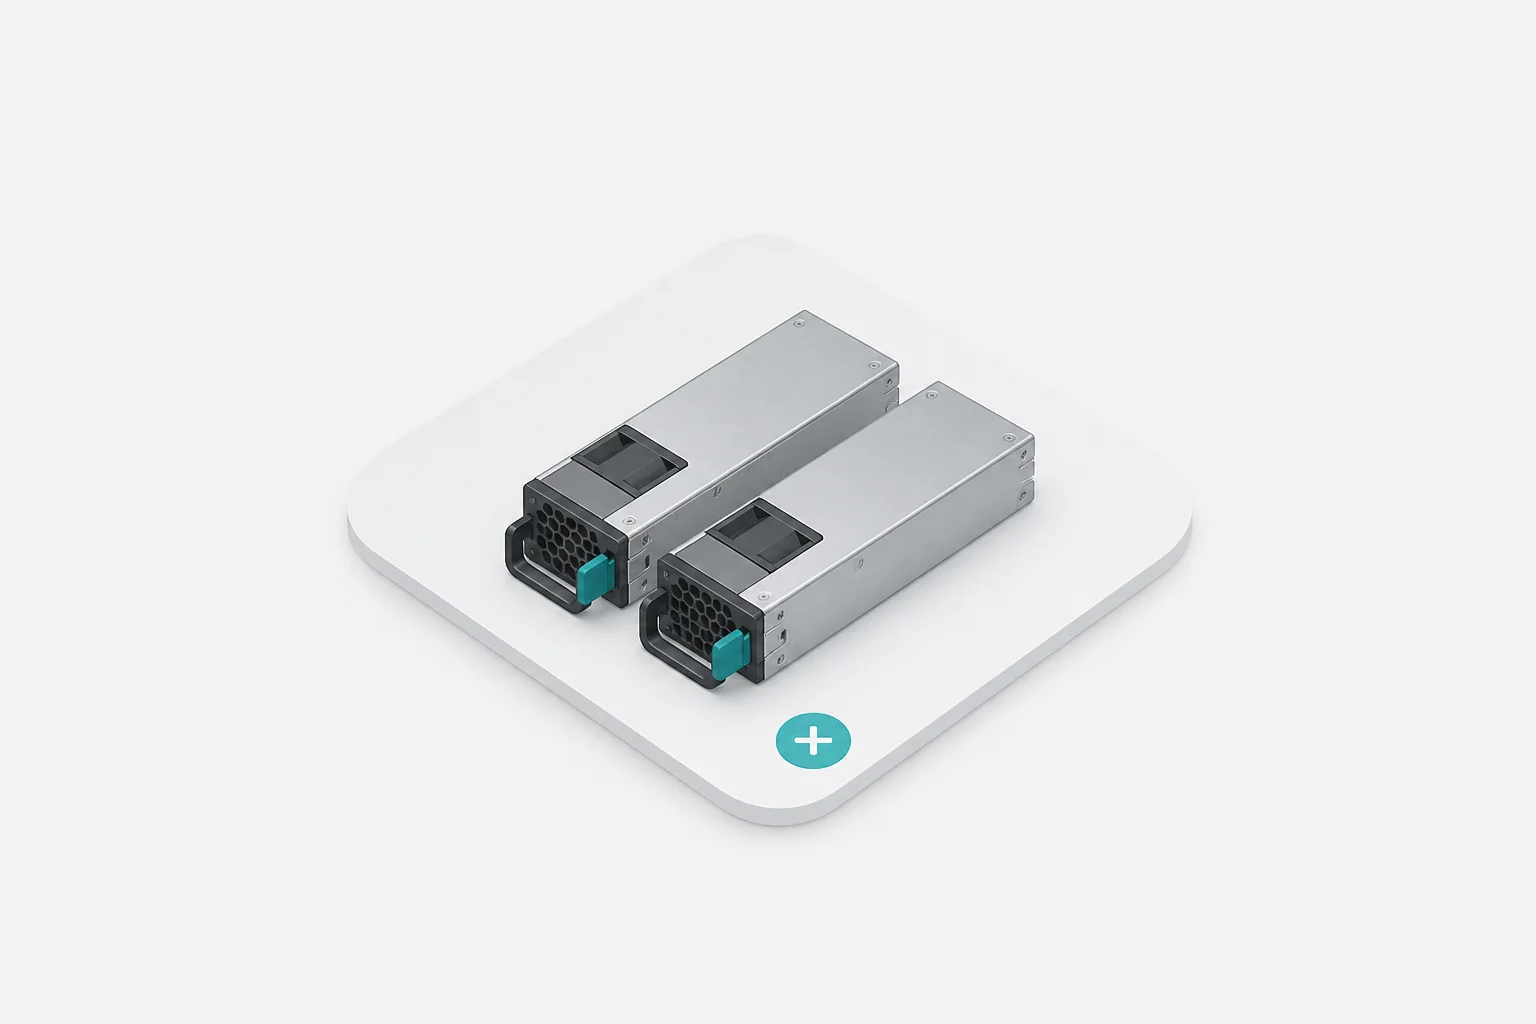
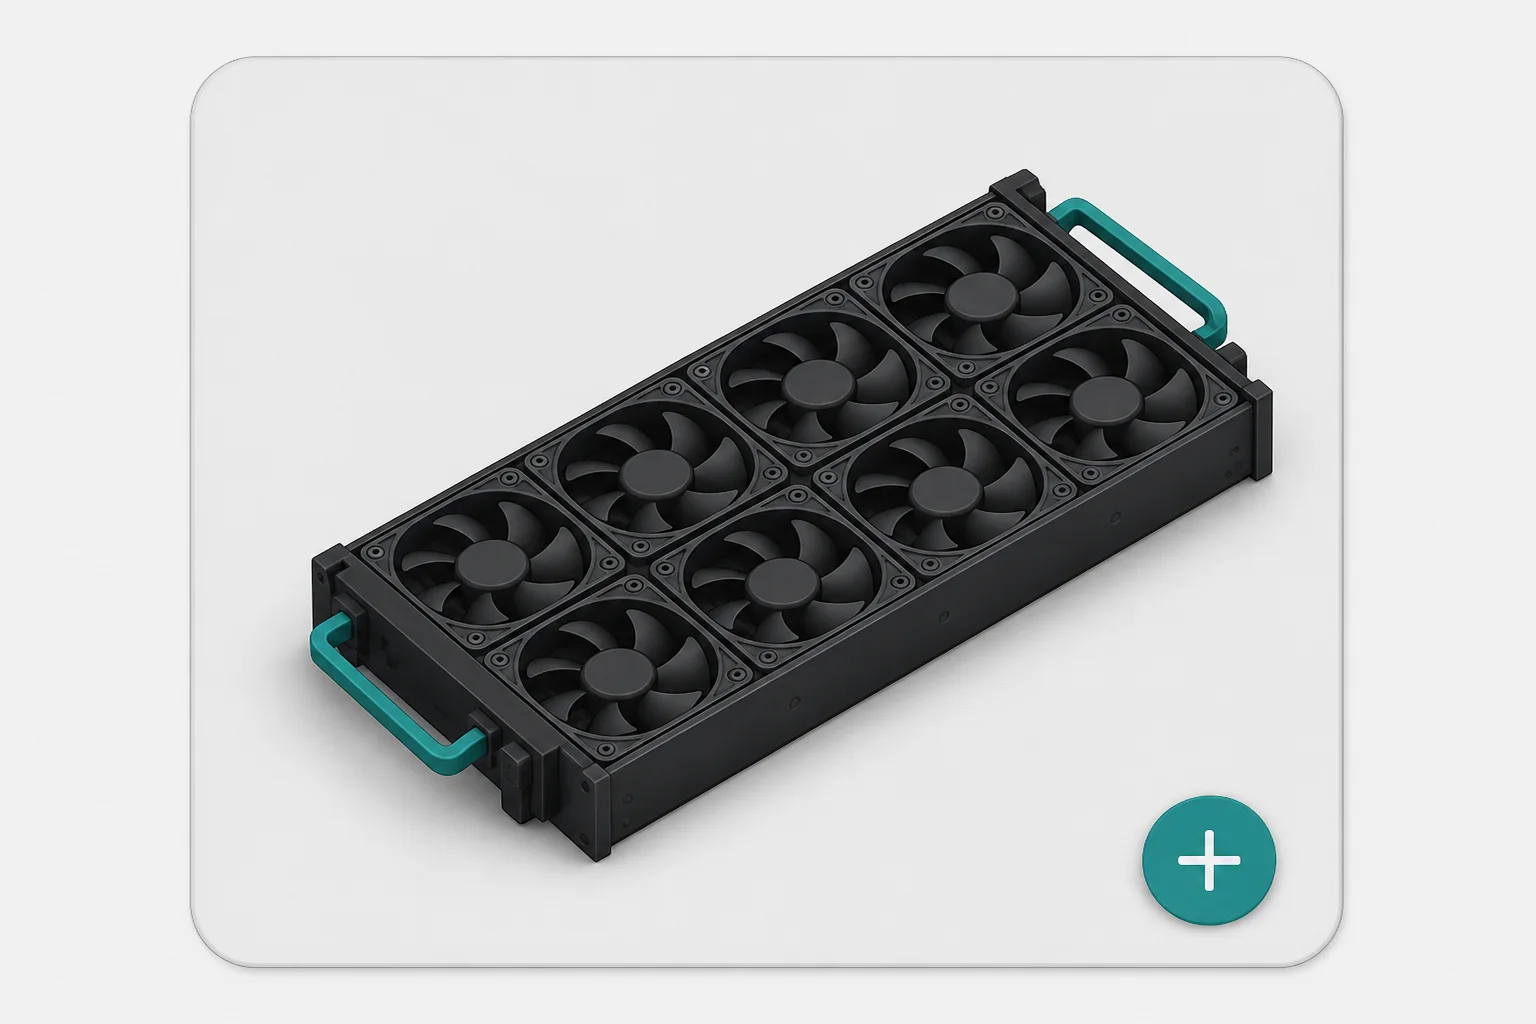
Illustration: zwei baugleiche Server-Netzteile als Einschübe nebeneinander, jedes mit Lüftergitter, Bügelgriff und Verriegelung.

02

Stromversorgung

PDU, CEE-Zuleitung und abgesicherte Kreise sind Anschlussmechanik, die Sie täglich betreiben. Neu ist das Lastprofil: Inferenz hält die GPUs nahe der TDP, die Anlage zieht ihre Anschlussleistung über Stunden als Dauerlast. Der Systemplan weist Anschlussleistung und Verbrauch je Lastprofil aus; Ihre Verteilung wird in der Bestandsaufnahme dagegen geprüft.

  • Redundante Netzteile

    Zwei Einschübe je Gerät, einzeln wechselbar. Ein Netzteilausfall hält die Anlage nicht an, solange die Auslegung die Reserve dafür vorsieht.

  • Zuleitung und Absicherung

    Querschnitt und Absicherung folgen der Anschlussleistung aus dem Systemplan. Die Bestandsaufnahme gleicht sie gegen Ihre vorhandene Verteilung ab, bevor ein Gerät bestellt wird.

Illustration: eine Lüfterreihe aus acht Axiallüftern in einem gemeinsamen Wechselrahmen mit zwei Griffen.

03

Kühlung und Luftweg

Front-to-Back und Blindplatten sind Ihr Tagesgeschäft. KI-Last verschiebt die Wärmemenge: Dauerlast hebt die Ablufttemperatur über die gesamte Betriebszeit konstant an. Ob der Raum das trägt, folgt aus der Anschlussleistung; die Bestandsaufnahme misst Zuluft, Luftweg und Abluft am Aufstellort.

  • Luftkühlung, der Regelfall

    Luft trägt bis in die Klasse mit acht gekoppelten GPU-Modulen: Lenovo führt sein SR685a V3 als luftgekühlten Server mit 15 Doppelrotor-Lüftern.

  • Flüssig-Hybrid (L2A)

    Der Wasserkreis bleibt im Gehäuse und gibt die Wärme dort an die Luft ab. Der Aufstellort bleibt damit ein reiner Luftraum ohne eigene Wasserinfrastruktur.

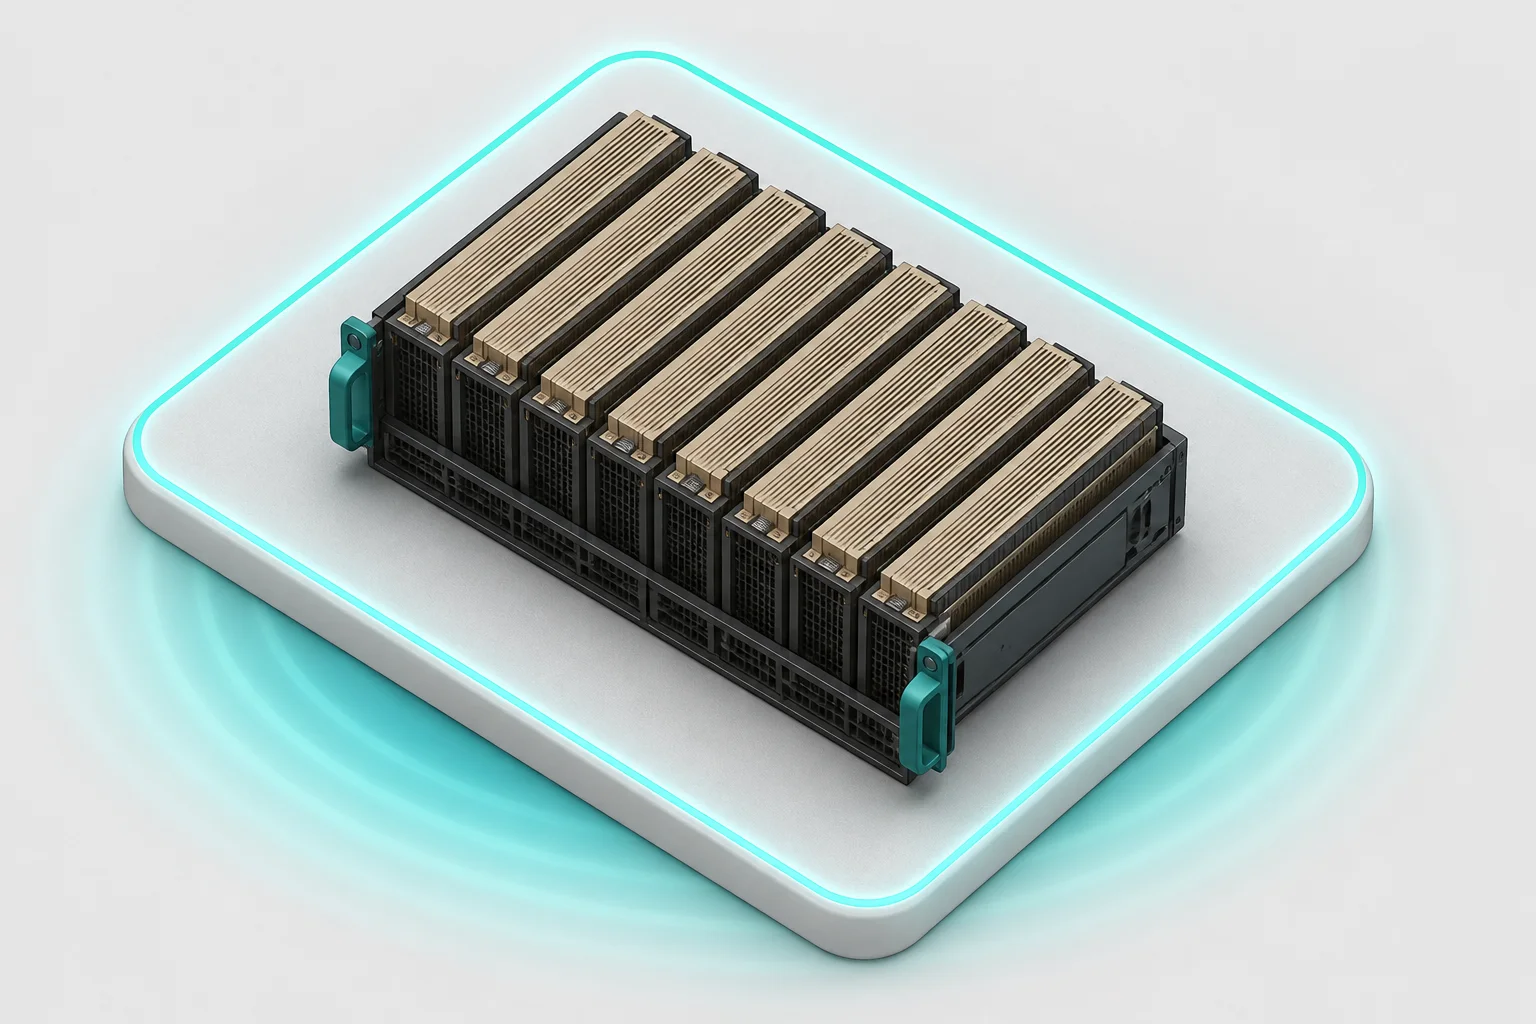
Illustration: ein GPU-Träger mit acht nebeneinander stehenden Beschleunigern samt Kühlkörpern auf einem hell hinterleuchteten Sockel.

04

GPU-Knoten

Der Grafikspeicher ist die harte Grenze: Modellgewichte plus KV-Cache der laufenden Anfragen müssen hineinpassen, sonst startet die Klasse gar nicht. Der KV-Cache wächst mit Gleichzeitigkeit und Kontextlänge und treibt die Auslegung damit stärker als die Modellgröße allein. Aus dieser einen Größe folgt der Rest: Netzteilklasse, Stellfläche, Gewicht.

  • PCIe-Karten

    Einzeln bestückt und später nachrüstbar, solange Steckplätze, Netzteilreserve und Luftdurchsatz es tragen. Der übliche Weg bis in die Scale-Klasse.

  • SXM-Module

    Auf einer Trägerplatine über NVLink zu einem Speicherverbund gekoppelt. Damit läuft ein Modell, dessen Gewichte auf einer einzelnen Karte nicht unterkommen.

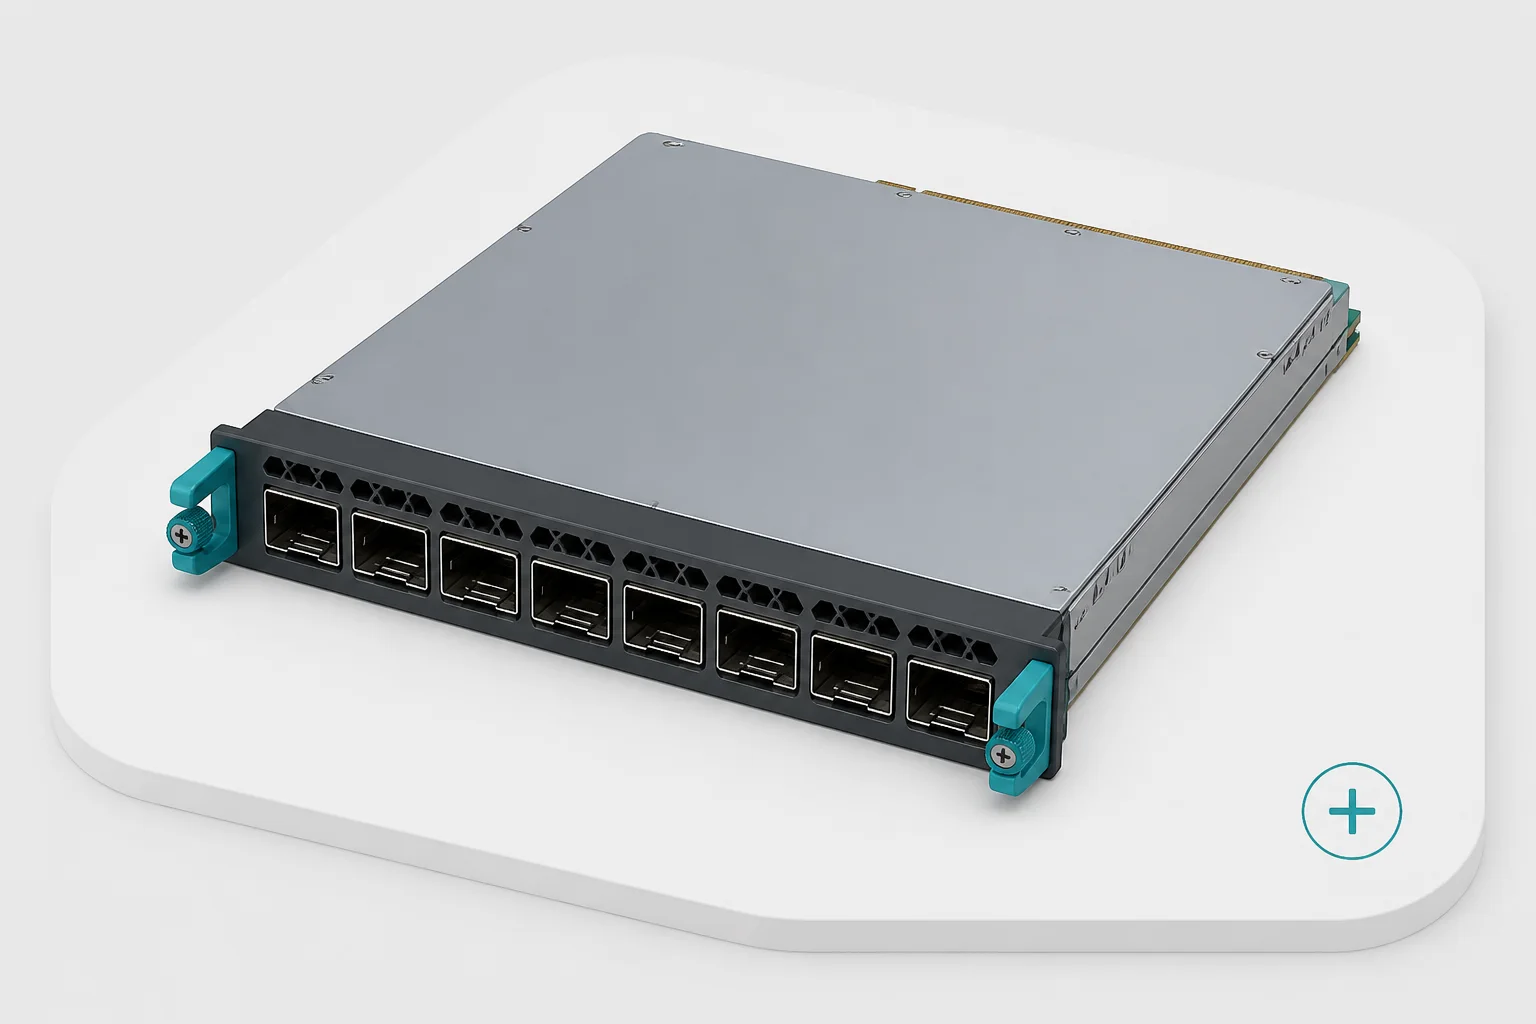
Illustration: ein Switch-Einschub mit acht Steckplätzen für optische Module an der Frontblende.

05

Netzwerk und Fabric

North-South bleibt Ihre Welt: eigenes Segment, benannte Regeln, Anbindung an Verzeichnisdienst und Ablagen. Dazu kommt East-West. Gekoppelte GPUs tauschen ihre Zwischenergebnisse über eine eigene Fabric aus, die das Produktivnetz nie berührt.

  • Anbindung ans Firmennetz

    Ein eigenes Segment mit benannten Regeln, angebunden über die strukturierte Verkabelung des Hauses. Darüber erreichen Ihre Mitarbeiter die Oberfläche und die Anlage Ihre Ablagen.

  • GPU-Fabric

    Erst bei gekoppelten Karten: eigene Links, eigene Topologie, eigener Adressraum. Der Switch am Rack-Kopf sieht diesen Verkehr nie.

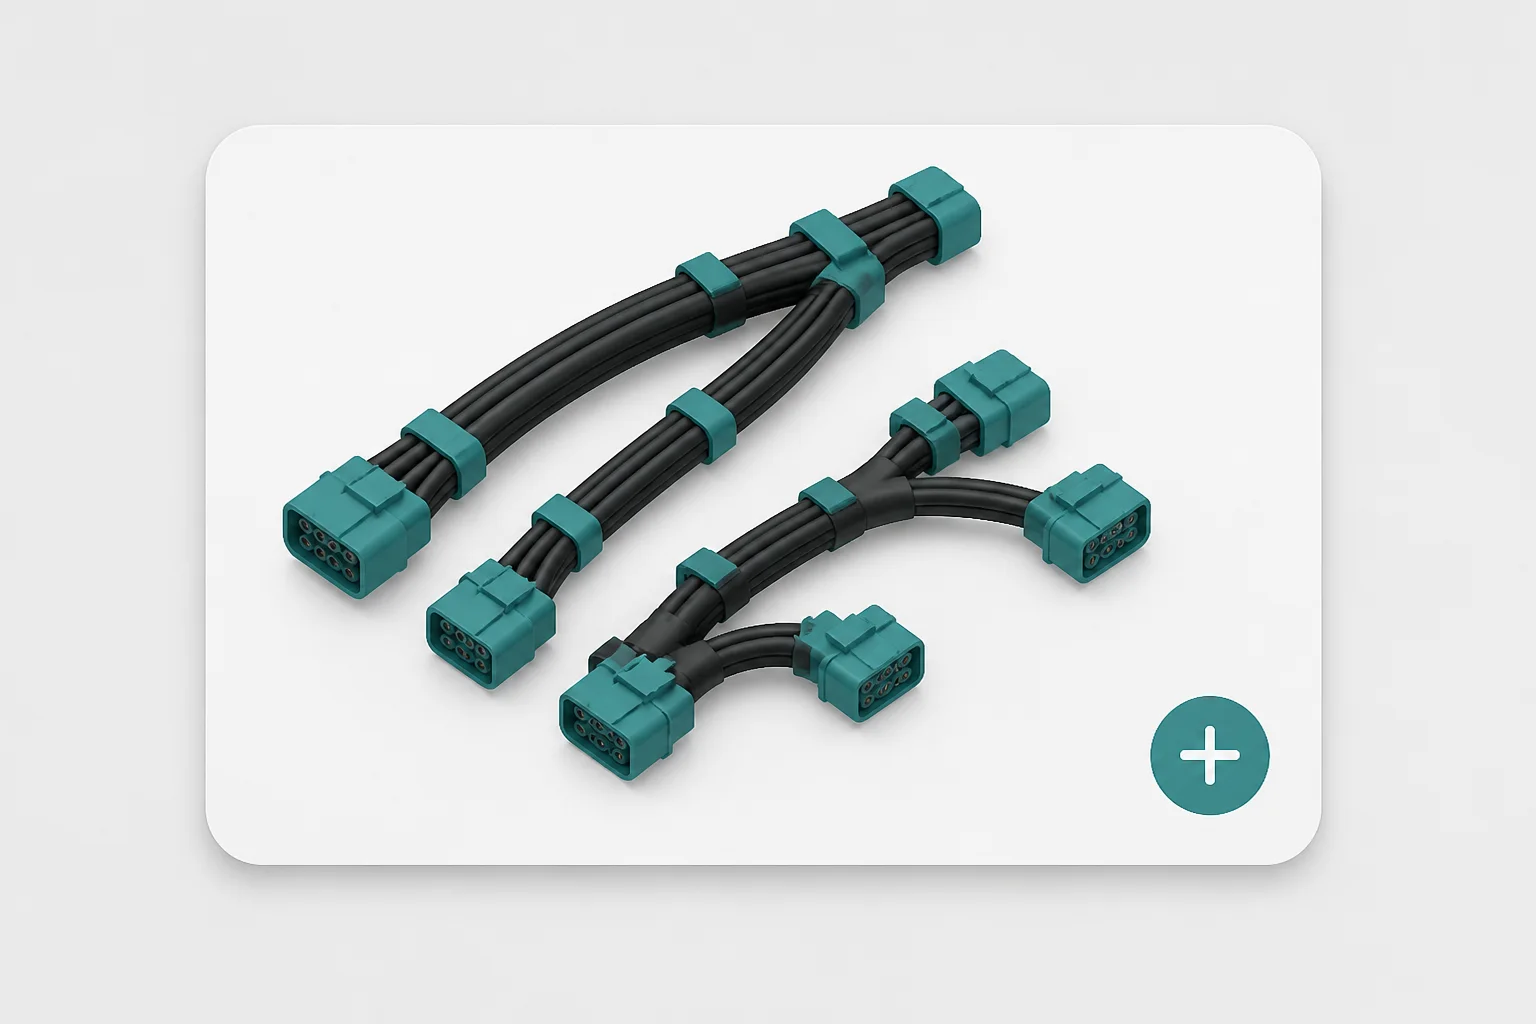
Illustration: konfektionierte Kabelbäume mit gebündelten Adern und codierten Steckern an beiden Enden.

06

Verkabelung

Konfektionierte, beschriftete Kabelbäume mit dokumentierter Gegenstelle — dieselbe Disziplin wie in Ihrer strukturierten Verkabelung. Der Unterschied ist die Dichte: Strom, Fabric und Management laufen auf engem Raum zusammen und teilen sich den Luftweg. Die Stückliste hält jede Verbindung fest; getauscht wird gegen dieselbe Liste.

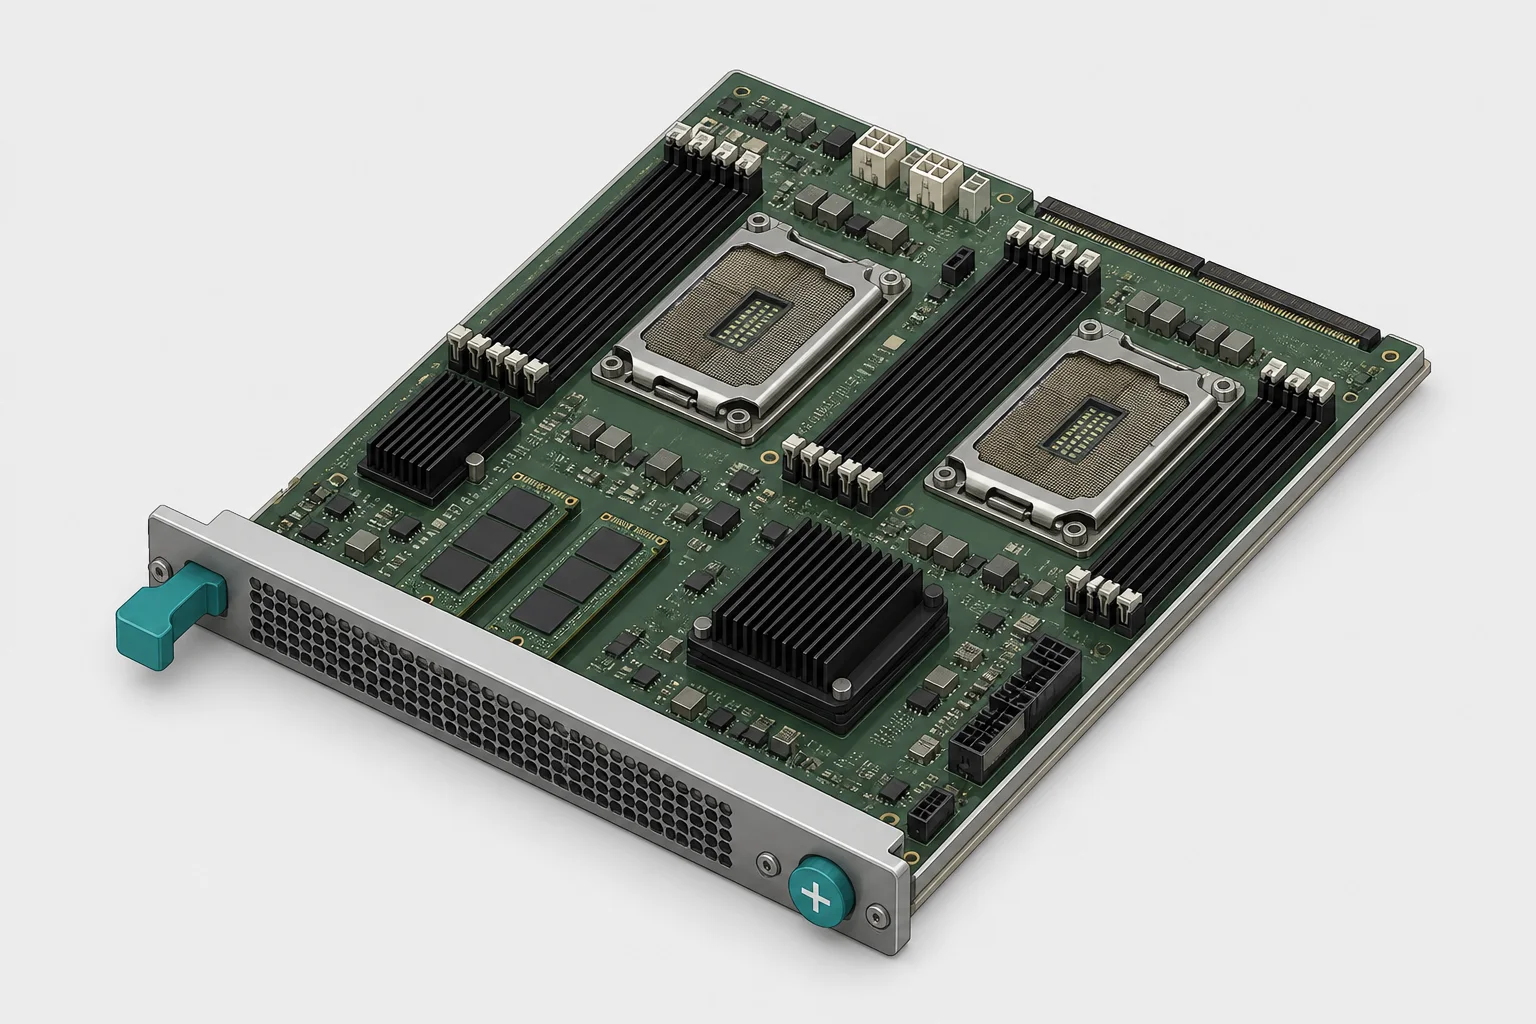
Illustration: eine Server-Hauptplatine mit zwei CPU-Sockeln, Speicherbänken zu beiden Seiten und zwei NVMe-Modulen hinter der Frontblende.

07

Host und Speicher

CPU, RAM und NVMe sind bei Ihnen Standardgrößen. Hier dienen sie den Karten: NVMe lädt die Modellgewichte mit hohem Durchsatz in den Grafikspeicher, RAM trägt Aufbereitung und Index, der Host hält die GPUs versorgt. Ein zu knapp ausgelegter Host bremst Karten aus, die rechnerisch reichen würden.

  • CPU, RAM, Boot-NVMe

    Kernzahl und Speicherbandbreite folgen der Zahl der Karten, der Arbeitsspeicher bekommt Reserve für Aufbereitung und Einbettung. Der Host ist die Stelle, an der eine Anlage still unter ihrer Auslegung bleibt.

  • NVMe für Gewichte, Index und Protokolle

    Kapazität nach Modellgröße, Umfang Ihrer Ablagen und Aufbewahrungsdauer der Protokolle. Beim Start wandern die Gewichte von hier in den Grafikspeicher.

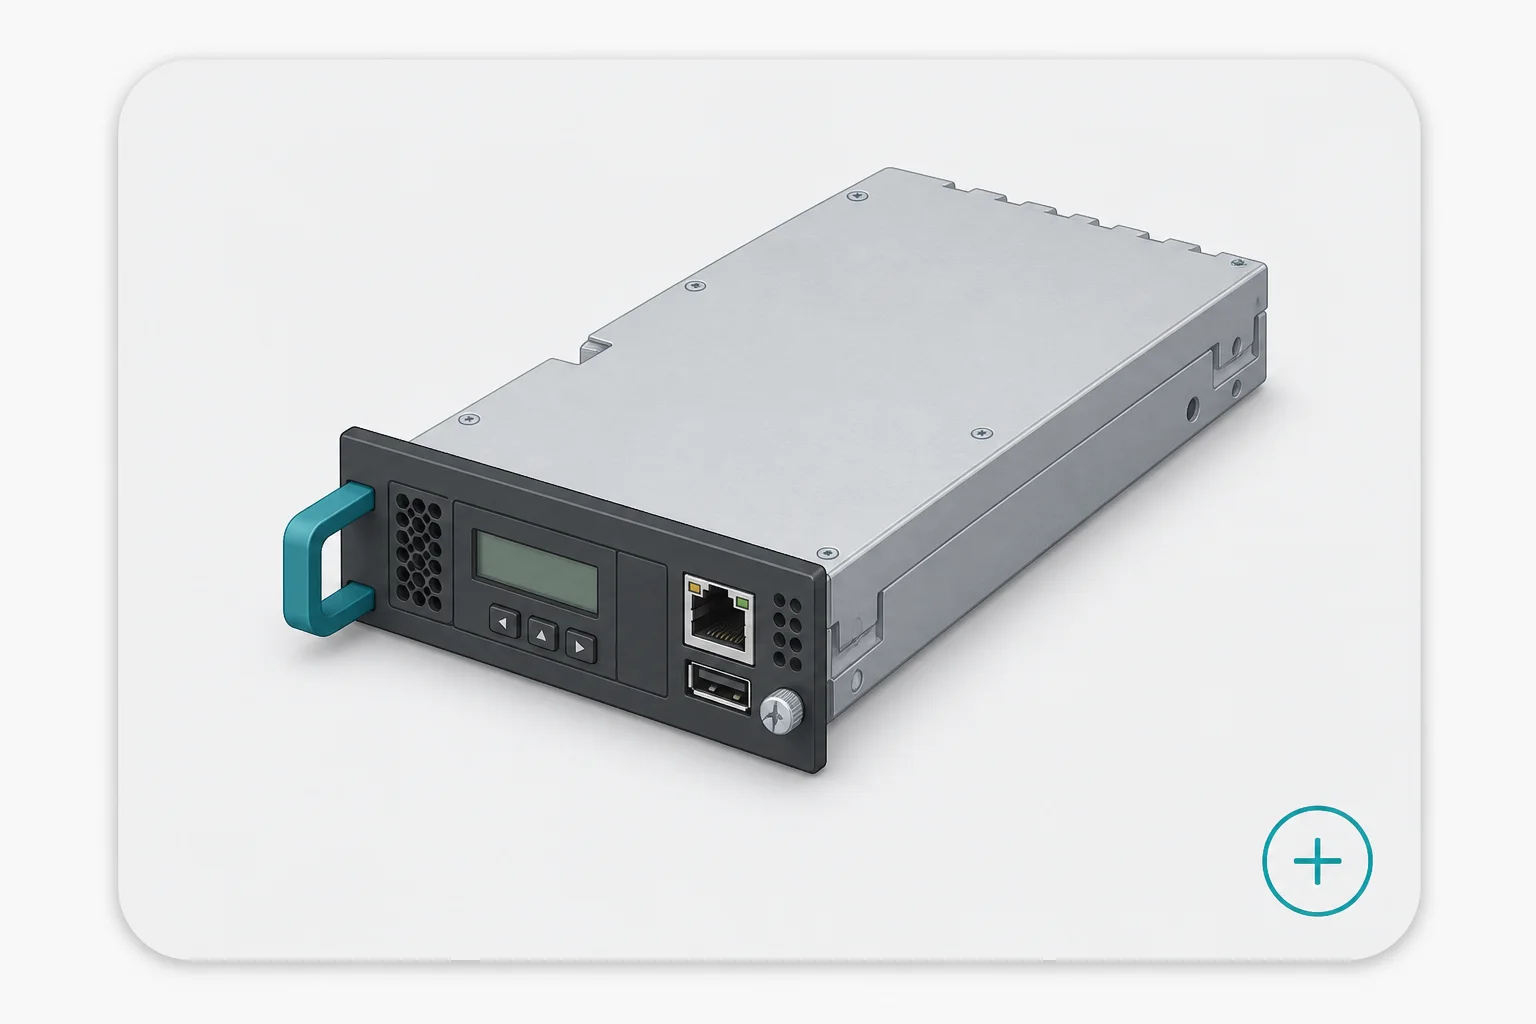
Illustration: ein Verwaltungsmodul als Einschub, mit Statusdisplay, drei Tasten, Netzwerkbuchse und USB-Anschluss an der Frontblende.

08

Verwaltung und Service

Out-of-Band-Management kennen Sie aus Ihrer Flotte; hier gilt dieselbe Mechanik: ein eigener Verwaltungszugang mit Zustand, Temperaturen und Firmwareständen, getrennt vom Produktivnetz. Fernzugriff darauf gibt Ihre IT frei, widerruflich und protokolliert. Störungen laufen über einen benannten Meldeweg; wie weit die Betreuung danach reicht, entscheidet die Betriebsstufe: Grundbetrieb, Betrieb mit Pflege oder Betrieb mit Bereitschaft.

Wo die Unterschiede liegen.

Vier Entscheidungen trennen eine kompakte Anlage von einem Rechenzentrumsprojekt. Sie fallen im Systemplan, und jede hat ein technisches Kriterium. Karte anklicken für die Begründung.

PCIe-Karten oder SXM-Module

PCIe-Karten stecken einzeln im Server und lassen sich später ergänzen; das trägt die meisten Anlagen im Mittelstand.

SXM-Module sitzen fest auf einer Trägerplatine und sind über NVLink direkt gekoppelt: Sie teilen sich den Speicher so eng, dass ein Modell darüber läuft, dessen Gewichte auf einer einzelnen Karte nicht unterkommen. Welcher Weg nötig ist, entscheidet der Speicherbedarf aus der Bestandsaufnahme — Gewichte plus KV-Cache bei Ihrer Gleichzeitigkeit.

Luftkühlung oder Flüssigkeit

Luft trägt weiter, als die Anschlussleistung vermuten lässt: Lenovo führt sein System mit acht gekoppelten GPU-Modulen ausdrücklich als luftgekühlten Server mit 15 Doppelrotor-Lüftern.

Wird Flüssigkeit nötig, gibt es Hybridlösungen, deren Wasserkreis im Server bleibt und die Wärme dort an die Luft abgibt; der Serverraum braucht dafür keine eigene Wasserinfrastruktur. Für die Klassen Team bis Scale ist Luftkühlung der Normalfall. Die Wärmemenge folgt aus der Anschlussleistung, und die Bestandsaufnahme misst Zuluft, Luftweg und Abluft am Aufstellort.

Ein Knoten oder gekoppelte GPUs

Der Speicherbedarf des Modells entscheidet: Bis in die Business-Klasse genügt ein Knoten mit ein bis zwei Karten.

Große MoE-Modelle brauchen mehrere gekoppelte GPUs, Frontier-Größe einen Verbund aus mehreren Knoten. Mit diesem Sprung ändern sich Stellfläche, Gewicht, Verkabelung und Anschlussleistung zugleich, und der East-West-Verkehr kommt als eigene Fabric hinzu. Die Klassen weiter unten nennen den jeweiligen Speicherwert; der Lasttest im Piloten prüft ihn gegen Ihre echten Vorgänge.

Tower oder Rack

Ein Tower steht im Technikraum und braucht keinen Serverschrank; damit lässt sich eine erste Anlage aufstellen, solange kein Serverraum existiert.

Ab der Business-Klasse ist das 19-Zoll-Rack der übliche Weg, weil PDU, Verkabelung und Luftführung dort geordnet zusammenkommen. Manche Gehäuse sind für beides ausgelegt und lassen sich vom Standgerät in einen 4U-Einschub umbauen. Was zum Aufstellort passt, klärt die Bestandsaufnahme vor der Gerätewahl, Bautiefe und Statik eingeschlossen.

Welche Hardware zu welcher Anwendung gehört.

Die vier Anlagenklassen von sinlu ordnen ein Vorhaben ein, bevor ein Gerät ausgewählt wird. Links steht die Klasse mit ihren Planungsgrößen, darunter die Anwendung, für die sie gebaut wird.

Team

Parameterklasse
8–14B
Speicher
ab 32 GB VRAM
Hardware
ein kompakter GPU-Knoten
Anwendung
Eine Abteilung arbeitet mit dem Wissen aus den eigenen Ablagen: Chat über Handbücher, Verträge und Projektordner, Suche mit Quellenangabe, Zusammenfassungen. Die Gleichzeitigkeit bleibt niedrig genug, dass ein bis zwei Karten in einem kompakten Gehäuse tragen, oft noch als Tower.

Business

Parameterklasse
24–35B
Speicher
ab 96 GB VRAM
Hardware
ein leistungsfähiger Knoten oder zwei GPUs
Anwendung
Mehrere Abteilungen arbeiten gleichzeitig, dazu kommen Besprechungsprotokolle und Agenten, die einen Vorgang über mehrere Systeme führen. Ab hier treibt die Gleichzeitigkeit den KV-Cache; die Anlage steht im Rack und trägt zwei bis vier Karten.

Scale

Parameterklasse
große MoE-Modelle
Speicher
ab 384 GB VRAM
Hardware
mehrere gekoppelte GPUs
Anwendung
Hohe Parallelität, lange Kontexte und spezialisierte Lasten wie Dokumentenstrecken über ganze Aktenbestände. Hier stehen viele PCIe-Karten in einem Gehäuse, und Netzteilklasse wie Luftweg werden zur Randbedingung; die Auslegung wird nach dem Lasttest im bezahlten Piloten verbindlich.

Pilot erforderlich

Frontier

Parameterklasse
Frontier-Größe
Speicher
ab 1.680 GB VRAM
Hardware
Rechenzentrums-Cluster mit mehreren GPU-Knoten
Anwendung
Frontier-Größe ist ein Rechenzentrumsprojekt: SXM-Module über NVLink gekoppelt, mehrere Knoten über eine eigene Fabric verbunden, eigene Planung für Stellfläche, Strom und Kühlung. Der Lasttest steht auch hier vor der Auslegung.

Pilot erforderlich

Die Werte sind Planungsgrößen für das Erstgespräch. Verbindlich wird die Auslegung mit dem Systemplan und, in den beiden oberen Klassen, mit dem Lasttest. Annahme: 16-Bit-Gewichte und KV-Cache an der Obergrenze der Klasse; die Reserve wächst mit gleichzeitigen Vorgängen und Kontextlänge.

Modelle und Anlagenklassen mit Quellen → Klassen und Grafikspeicher im KI-Labor am 3D-Modell ausprobieren →

Die Gerätewahl ist Teil der Leistung.

sinlu ist an keinen Hersteller gebunden. Je Vorhaben bewerten wir die Anlagenklasse, die Lieferzeit, den Garantieumfang und den Weg zu Ersatzteilen. Dazu gehört, welche Karten ein Gehäuse freigibt und welche Generation davon gerade lieferbar ist.

Das Ergebnis steht im Systemplan: das Gerät benannt, die Bestückung begründet, die Beschaffung inklusive. Diese Marktbeobachtung über Herstellergenerationen hinweg ist die Arbeit, die Sie mit der Anlage einkaufen.

Wie der Systemplan entsteht →

Fragen zur Hardware

Warum steht die GPU im Zentrum der Auslegung?

Weil ihr Speicher die harte Grenze setzt. Modellgewichte und der KV-Cache der laufenden Anfragen müssen zusammen in den Grafikspeicher passen; reicht er nicht, startet das Modell gar nicht oder es wird unbrauchbar langsam. Der KV-Cache wächst dabei mit Gleichzeitigkeit und Kontextlänge, ist also eine Frage Ihres Lastprofils. CPU, Arbeitsspeicher, NVMe und Netzwerk werden anschließend auf diese Größe hin ausgelegt.

Passt ein GPU-Knoten in unser vorhandenes Rack?

Das entscheidet sich an vier Punkten. Bautiefe und Schienenmaß, weil GPU-Systeme tiefer bauen als übliche 1U/2U-Hosts. Statik und Lastverteilung, weil das Gewicht eines voll bestückten GPU-Systems in einer anderen Größenordnung liegt. Die verfügbaren PDU-Anschlüsse und abgesicherten Kreise. Und der freie Luftweg vor und hinter dem Schrank. Die Bestandsaufnahme prüft das am Schrank, bevor bestellt wird.

Welche GPUs verbaut sinlu?

Die Auswahl folgt dem Speicherbedarf der Anlagenklasse und wird im Systemplan benannt, sobald Aufgaben und Lastprofil bekannt sind. Welche Karten ein Gehäuse aufnehmen darf, steht in den Produktunterlagen des Herstellers; welche davon in Ihrer Anlage sitzt, benennt der Systemplan mit Begründung. Neben der Rechenleistung zählen dabei Verfügbarkeit, Garantie und Ersatzteilweg.

Reicht Luftkühlung für eine KI-Anlage?

In den Klassen Team bis Scale in aller Regel ja. Lenovo führt selbst ein System mit acht gekoppelten GPU-Modulen als luftgekühlten Server. Die Grenze zieht der Raum: Zulufttemperatur, freier Luftweg vor und hinter dem Schrank und ein Abluftweg, der die Dauerlast aus dem Raum bringt. Die Bestandsaufnahme misst das am Aufstellort.

Kann ein vorhandener Server eine GPU aufnehmen?

Das hängt an drei Dingen: freie PCIe-Steckplätze in voller Bauhöhe und doppelter Breite, Netzteilreserve für die zusätzliche Dauerlast und genug Luftdurchsatz im Gehäuse für eine Karte ohne eigenen Lüfter. Viele Bestandsserver erfüllen das erste und scheitern am zweiten oder dritten. Die Bestandsaufnahme sieht sich Ihre Geräte einzeln an; wo ein vorhandener Server trägt, sagen wir das, auch wenn es den Auftrag kleiner macht.

Was passiert bei einem GPU-Defekt?

Die Meldung geht an eine benannte Adresse, sinlu bestätigt den Eingang und ordnet ein, ob eine Sofortmaßnahme, eine geplante Behebung oder eine Beobachtung folgt. Eine Anlage mit mehreren Karten arbeitet währenddessen mit verringerter Kapazität weiter, soweit die Auslegung das trägt. Der Beschaffungsweg für die tragenden Bauteile liegt mit derselben Stückliste vor, aus der die Anlage gebaut wurde.

Weitere Fragen zu Ablauf, Datenfluss und Wartung beantworten die Fragen und Antworten zu lokalen KI-Anlagen.

Aus dem Aufbau wird ein Systemplan.

Im Erstgespräch nehmen wir Aufgaben, Gleichzeitigkeit, Datenräume und vorhandene Infrastruktur auf. Daraus entsteht der Systemplan: Gerät, Bestückung, Aufstellort, Anschlussleistung und Betrieb, jeweils benannt und begründet.